人脸核验与静默活体
项目地址:https://github.com/Samzhaohx/FaceVerify
此前用 face_recognition 做过一个人脸识别 demo,实现了多线程采集、MJPEG 推流和 pickle 特征库,功能上可以正常演示。但它无法通过最基本的一项检验:把一张打印出来的照片放到摄像头前,系统依然会输出”识别成功”。
这次在保留原有工程骨架的前提下重写了算法,并补充:跨帧稳定的身份 ID、静默活体检测、以及基于双阈值的风控分级。使用场景收窄为单人核验——同一时刻只判定一个人是否为注册本人、是否为活体。
整体链路
系统拆为采集与推理两条线程。采集线程只负责取帧并写入有界队列,队列满时丢弃最旧帧;推理线程从队列取最新帧,完成检测、追踪、识别、活体与标注,最后编码为 JPEG 供推流。
| 频率 | 处理内容 |
|---|---|
| 每 2 帧 | SCRFD 检测 → 2D106 关键点 → 追踪更新 |
| 其余帧 | 卡尔曼预测,框体继续移动,不执行模型推理 |
| 新轨迹 / 每 15 帧 | ArcFace 特征提取 → 人脸库比对 |
| 每 2 帧 | MiniFASNetV2 活体判定 |
| 每帧 | 风控分级 → 中文标注 → JPEG 编码 |
算法替换
检测从 Haar 级联换成 SCRFD,识别从 dlib 的 128 维换成 ArcFace 的 512 维,活体使用 MiniFASNetV2,追踪使用轻量版 ByteTrack。四个模型统一走 ONNX Runtime,不引入 PyTorch 或 TensorFlow,部署只需要 pip install。
检测:SCRFD 的输出解码
SCRFD 一次前向输出三个尺度的分类得分、边界框和关键点。边界框不是直接坐标,而是相对 anchor 中心的距离,需要按 stride 还原:
1 | for idx, stride in enumerate(self._strides): # stride = 8, 16, 32 |
这段代码里有两个容易出错的地方。一是 anchor 数量:传入的宽高已经是”特征图尺寸”(det_h // stride),函数内部不能再除一次 stride,否则 anchor 数会少 64 倍,检测结果直接为空。二是合并方式:各尺度的命中数通常不相等,np.vstack 会把 1-D 数组当作行来堆叠,长度不一致时抛异常,必须用 np.concatenate。后一个问题在单张高清图上不会暴露——三个尺度各命中一个目标时长度恰好相等——只有换成视频流才偶发。
对齐:5 点相似变换
检测得到 5 个关键点(左右眼、鼻尖、左右嘴角),用最小二乘相似变换把它们映射到 ArcFace 的标准模板上,再裁剪为 112×112。这里自己实现了 Umeyama 算法,避免为了一个仿射矩阵引入 scikit-image。
1 | dst = ARC_TEMPLATE_112.copy() |
模板换算只影响非 112 尺寸(如 192×192 的 2D106 输入),但它决定了后续所有坐标的正确性。早期版本对 192 也采用”112 等比放大”,对齐图被压扁约 40%,反投影回原图后关键点全部散落在人脸之外,而且不会报任何错误。
识别:ArcFace 与特征库
w600k_mbf 输出 512 维特征,做 L2 归一化后直接以点积作为余弦相似度。人脸库支持一人多张照片,匹配时对单张取最大相似度,而不是先做平均——平均会把不同姿态的差异抹平,反而降低区分度。
1 | sims = self.embeddings @ emb # 双方均已归一化,点积即余弦 |
活体:MiniFASNetV2
活体模型对输入裁剪方式极其敏感,官方协议是将人脸框外扩 2.7 倍裁成正方形,缩放到 80×80,直接送入模型(BGR、0~255,不做均值方差归一化,模型内部自带 BN)。因此裁剪函数需要严格保证结果落在图像内部:
1 | side = min(max(x2 - x1, y2 - y1), float(min(w, h))) |
这里刻意不做任何填充。原因见下一节。
三个关键问题
活体:裁剪尺度决定结果
最初的活体实现采用多尺度集成——2.7 倍与 4.0 倍各裁一次,加水平翻转,四个视图的 softmax 取平均,看上去比单一尺度更稳妥。实际测试中有一张真人自拍只有 0.58,被判为活体异常。
将尺度拆开分别测试,五张不同角度的真人照片结果如下:
| 裁剪尺度 | 五张照片的真人分数 | 表现 |
|---|---|---|
| 2.0 / 2.4 / 2.7 | 全部 1.000 | 稳定 |
| 3.2 | 0.999 / 0.999 / 0.899 / 0.991 / 0.996 | 开始波动 |
| 4.0 | 0.936 / 0.985 / 0.191 / 0.859 / 0.975 | 明显波动 |
| 4.6 | 0.209 / 0.816 / 0.004 / 0.670 / 0.829 | 失效 |
MiniFASNetV2 的训练裁剪协议是固定的(外扩 2.7 倍)。放大到 4 倍时,画面中混入大量头发、背景与镜片反光,已偏离训练分布;分布外输入的 softmax 概率不具备判别意义,参与平均只会拉低正确视图的结论。最终改为单一尺度 2.7 加水平翻转(两个视图,仅用于降噪),五张真人全部 1.000,单帧耗时由 5ms 降至 2.6ms。
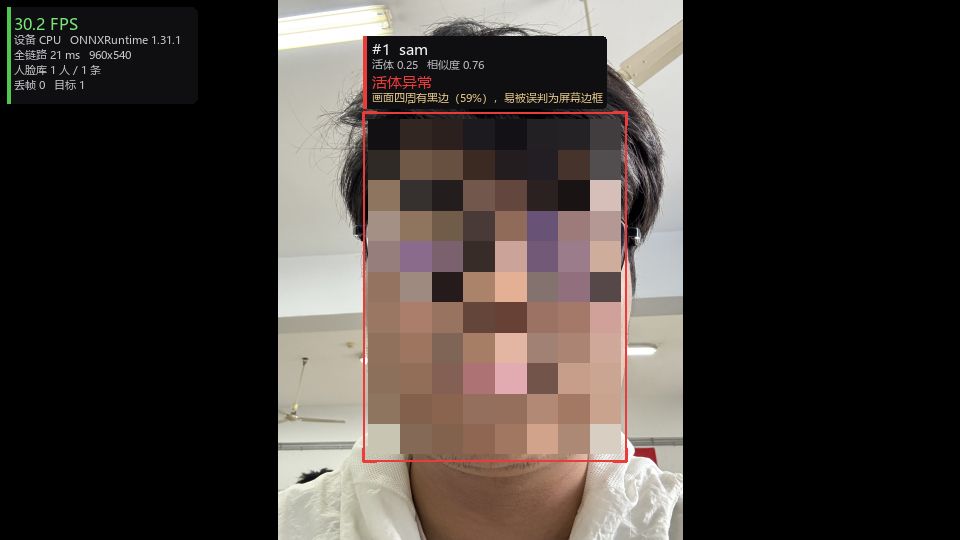
同一时期还有另一个现象需要解释:自测时整段视频全部判为活体异常,分数 0.03,而同一张照片单独运行是 1.000。先验证是否与人脸尺寸相关,把人脸从 1251px 逐档缩到 120px,结果全部为 1.000,可以排除尺寸因素。将裁剪图保存下来查看,才定位到原因——竖构图素材被 letterbox 到 1280×720 后,人脸两侧各有一条纯黑边,裁剪图外圈 59% 的像素为纯黑。仅把填充方式从黑色改为边界复制,分数立刻回到 1.000。
模型的负样本中包含大量”照片或打印件置于屏幕”的样本,纯黑矩形边界是其中的强特征。因此补黑边等于主动为真人画面加上屏幕边框,这是预处理引入的语义错误,与模型本身无关。
106 点重对齐:数据与直觉相反
SCRFD 已经输出了 5 个关键点,足够用于对齐。但项目中同时加载了 2D106 关键点模型,直觉上关键点越多对齐越准,于是尝试用 106 点中的瞳孔、鼻尖、嘴角重算 5 点,再做一次对齐。
索引不能凭猜测。做法是在一张已经对齐到 192×192 的人脸上,模板 5 点的位置是已知的,寻找距离这些位置最近的 106 点下标,并用五张照片投票。嘴部两个点的投票结果一致,眼部则不一致,这个信号当时没有被重视。
按投票结果计算的同人相似度如下(同一人 5 张照片两两比较):
| 5 点来源 | min | mean | max |
|---|---|---|---|
| SCRFD 原生 5 点 | 0.546 | 0.654 | 0.750 |
| 106 点重映射(投票最优) | 0.504 | 0.623 | 0.782 |
| 106 点重映射(初版索引) | 0.401 | 0.573 | 0.752 |
结果不仅没有提升,反而下降。原因在于两类模型的目标不同:SCRFD 的 5 点是端到端为”对齐”这一目标回归得到的,位置精度本身就是训练目标;而 2D106 是在已经对齐过的 192 裁剪图上预测 106 点,其输出自带对齐残差,反投影回原图相当于叠加了一次误差。用下游模型的输出去修正上游模型的输出,方向本身就是错的。
最终 106 点只保留两个用途:为活体计算裁剪框(关键点外接框比检测框更贴合人脸,不易带入耳朵与背景),以及在画面上可视化对齐质量。ArcFace 的对齐仍然使用 SCRFD 的 5 点。相关代码保留,结论与数据写在注释中,避免后续重复同样的改动。
相似度抖动:轨迹内特征融合
系统跑起来后出现一个问题:同一人在画面中保持不动,状态会在”验证通过”与”身份不匹配”之间反复切换。记录每帧的相似度后可以看到,60 帧内数值在 0.32 到 0.91 之间波动,其中 7% 的帧低于阈值。
抖动来源包括运动模糊、JPEG 压缩噪声、关键点逐帧漂移,以及检测帧与预测帧之间关键点质量的差异。处理方式是在同一轨迹内对特征做指数平滑,再用融合后的向量与库比对:
1 | prev = cache.get("emb_ema") |
实测结果:
| 新帧权重 | mean | min | std | 低于阈值的帧 |
|---|---|---|---|---|
| 1.0(不平滑) | 0.865 | 0.317 | 0.178 | 7% |
| 0.5(默认) | 0.909 | 0.746 | 0.063 | 0% |
| 0.3 | 0.913 | 0.862 | 0.034 | 0% |
标准差由 0.178 降至 0.063,阈值附近的跳变基本消失。权重取 0.5 是稳定性与响应速度的折中;0.3 更稳定,但融合状态绑定在 track_id 上,换人会产生新轨迹并重建缓存,因此实际影响很小。
风控分级与可解释输出
身份相似度与活体置信度分别设置阈值,判定顺序上活体优先——照片上的人可能确实是本人,但业务上必须拒绝,因此活体构成一票否决:
1 | # 略去人脸库为空与"身份确认中"两个分支 |
四种状态对应四种框色:通过为绿、活体异常为红、身份不匹配为黄、未知人员为白。
活体判定失败时,除状态外还会输出具体原因。原因来自与模型输入同一张 80×80 图上的三项指标——平均灰度、Laplacian 方差、外圈近黑像素占比:
| 提示 | 触发条件 |
|---|---|
| 画面四周有黑边(xx%) | 外圈近黑像素占比 ≥ 0.35,且人脸曝光正常 |
| 人脸偏小(xx px) | 人脸宽度 < 110 |
| 画面偏暗 / 过曝(xx) | 平均灰度 < 55 或 > 205 |
| 画面模糊(清晰度 xx) | Laplacian 方差 < 12 |
| 纹理特征强烈异常 | 上述指标均正常,模型仍判定为攻击 |
需要说明的是,这些指标只用于解释,不参与判定。实测将画面压暗到 22%、加入 σ=12 的高斯模糊、或把人脸缩到 70px,MiniFASNetV2 均仍输出 1.000,说明它对这类画质退化并不敏感,真正敏感的是边框、材质等结构特征。若用”亮度低”作为判假依据,会得到与实际相反的结论。
工程实现要点
采集与推理分离
cv2.VideoCapture.read() 是阻塞调用,在 30fps 下每次约 33ms。若直接在 Flask 的响应生成器中调用,会带来三个问题:推理被 IO 阻塞、每个浏览器连接各占一个读取循环、网络变慢时帧在缓冲区累积导致延迟持续增大。因此采集独立成线程,写入容量为 2 的队列,满时丢弃最旧帧;Flask 只读取推理线程产出的最新 JPEG,不直接接触摄像头。
Windows 下还需要注意两点:后端优先选择 CAP_DSHOW(MSMF 打开慢且对 MJPG 支持较差),以及显式设置 CAP_PROP_FOURCC = 'MJPG'——否则 720p 下会受 YUY2 的 USB 带宽限制,帧率降到个位数。
追踪与结果缓存
追踪使用 ByteTrack 的两级关联:高分检测先与现有轨迹匹配,低分检测只用于延长轨迹生命周期、不新建轨迹。关联采用按 IOU 降序的贪心匹配而非匈牙利算法——画面中目标数为 1 至 3,两者结果几乎等价,却能省去 scipy 依赖。
每条轨迹缓存身份结果与活体分数,识别每 15 帧重算一次,活体每 2 帧重算一次。实测 ArcFace 调用量下降约 93%,而身份更新的延迟控制在 0.5 秒以内。
镜像预览
界面需要自拍视角的左右翻转效果。直观做法是在采集端翻转一次,让整条链路运行在镜像帧上,但实测表明这不合适:同一张脸镜像后送入 ArcFace,与库内样本的相似度会从 1.000 降至 0.909~0.949,说明模型并非严格翻转不变;此外翻转后再绘制文字,文字会变成反向。
最终方案是分析链路运行原图,出图前才翻转像素,并对人脸框坐标做镜像映射,文字最后绘制:
1 | frame = cv2.flip(frame, 1) |
验证方式是对同一段序列分别以开启、关闭镜像运行,相似度均为 0.958、活体均为 0.998,确认分析结果未受影响。
运行效果
单人核验,960×540,纯 CPU(测试机未安装 CUDA 运行时,ONNX Runtime 自动降级)。界面如下:
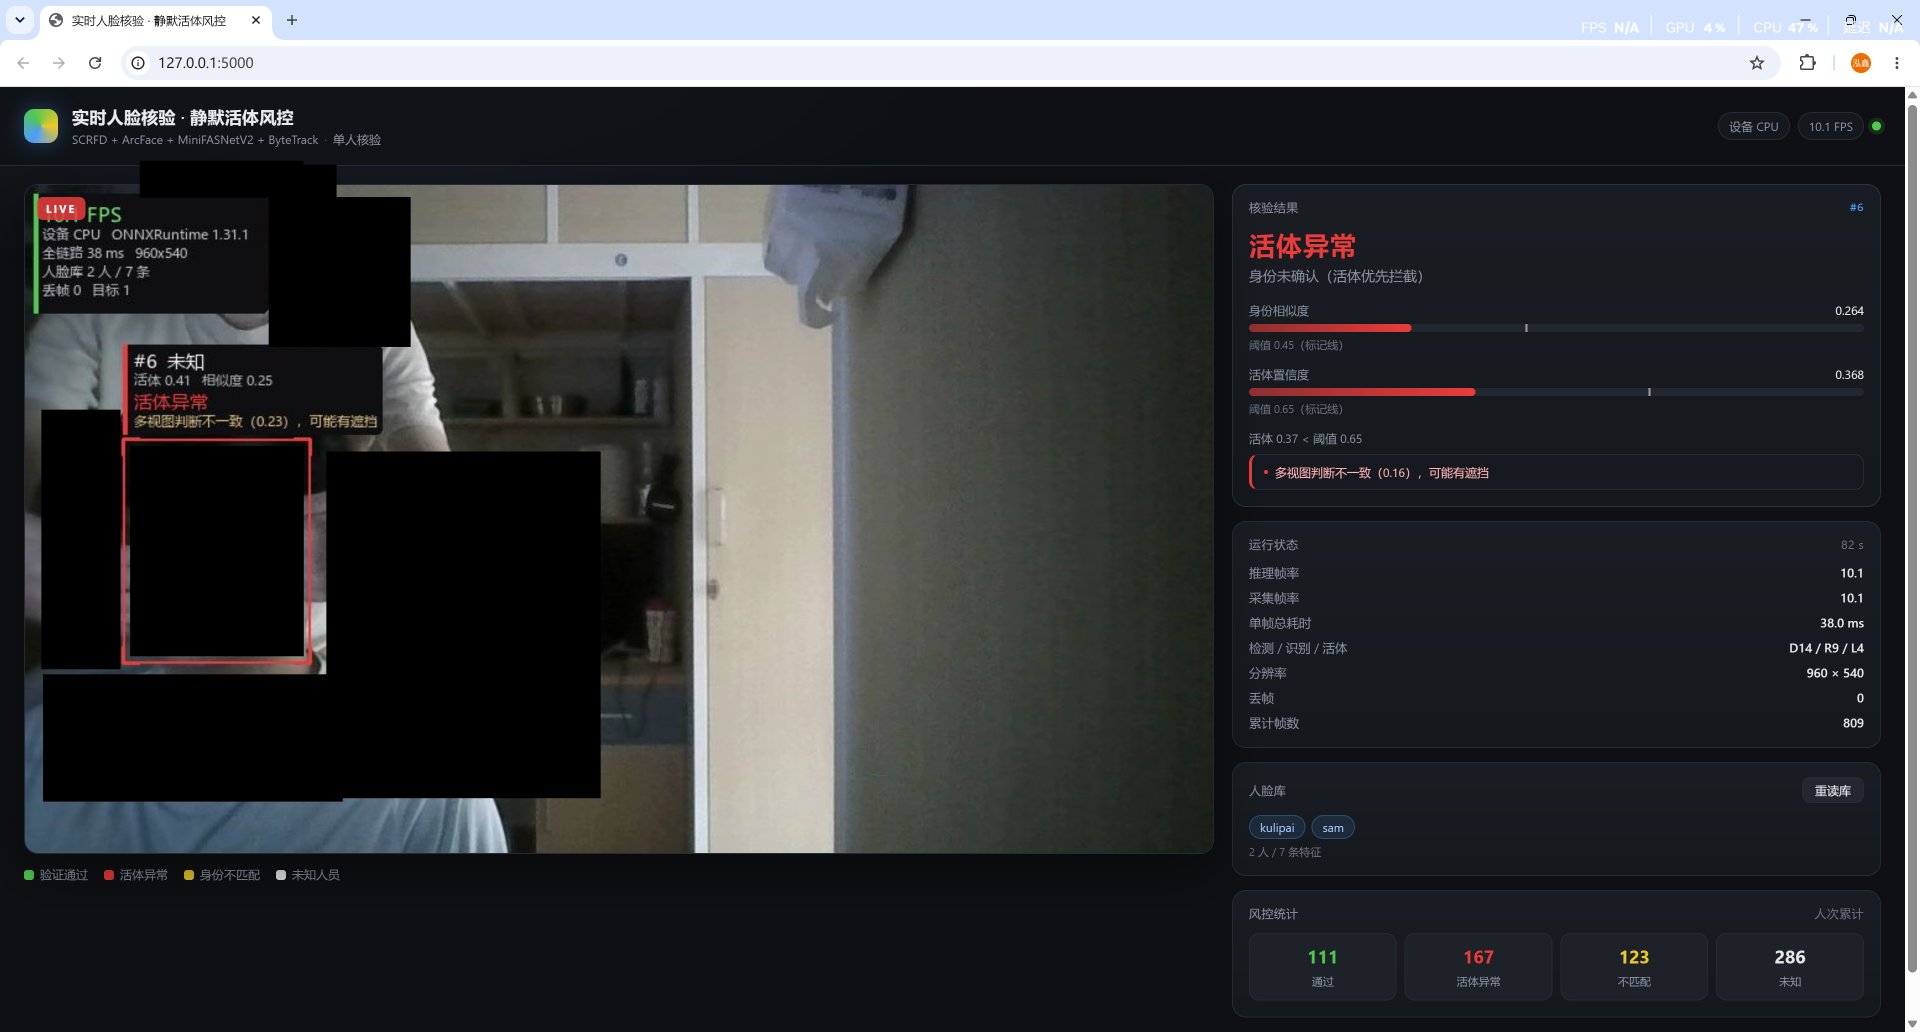
左侧为 MJPEG 实时画面,右侧依次为核验结果(状态、相似度与活体两条带阈值刻度的进度条、失败原因)、运行状态(帧率、耗时拆解、分辨率、丢帧、累计帧数)、人脸库与四级风控的累计计数。图中底部计数为调试过程中的累计值,不代表识别准确率。
这张截图里有一处值得注意:采集帧率与推理帧率同为 10.1。算法侧拆解为 D14 / R9 / L4(检测 14ms、识别 9ms、活体 4ms),加上标注与编码,单帧约 38ms,按此速度应能达到 26 FPS,实际只有 10,说明瓶颈在采集端——当时浏览器同时在推流、前端面板在轮询,机器负载较高。排查帧率问题时,应先确认采集帧率,再考虑优化模型。
放大后的画面标注:
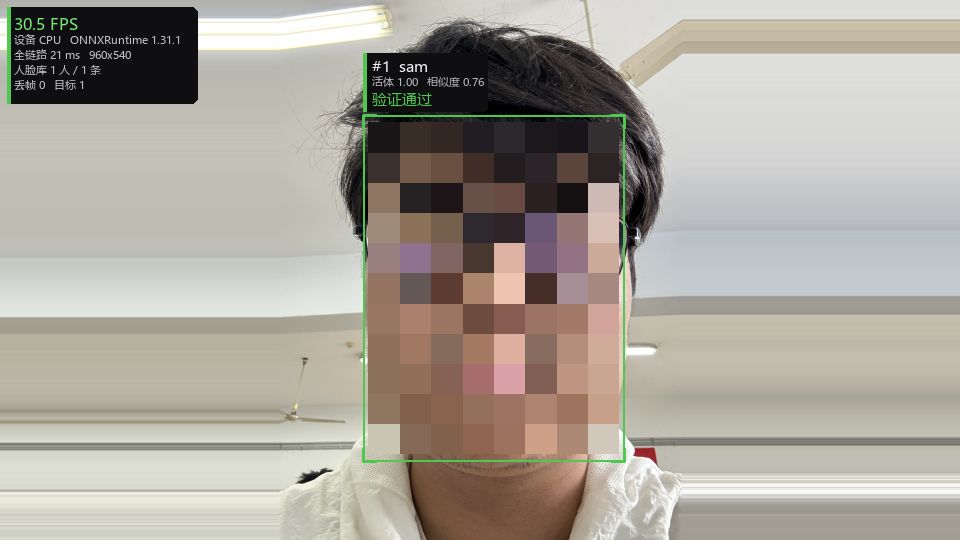
标注为三行:追踪 ID 与姓名、活体分数与匹配相似度、风控状态;未通过时追加第四行具体原因。左上角为帧率、推理设备与全链路耗时、人脸库规模与丢帧数。
单帧耗时(空载实测):
| 阶段 | 耗时 |
|---|---|
| SCRFD 检测 | 6.6 ~ 11.0 ms |
| 2D106 关键点 | 3.0 ~ 4.0 ms |
| ArcFace 特征 | 5.0 ~ 7.6 ms |
| MiniFASNetV2 活体 | 2.2 ~ 3.5 ms |
| 中文标注 | 2.6 ~ 4.5 ms |
| JPEG 编码 | 1.0 ~ 2.5 ms |
| 合计 | 11 ms(画面无人)/ 27 ms(有人) |
端到端帧率的上限在摄像头。同一台机器更换采集分辨率的实测结果为:1280×720 为 15.4 FPS,960×540 为 26.3 FPS,640×480 为 30.3 FPS。默认分辨率取 960×540——该分辨率下 40~80cm 距离的人脸仍有 200 余像素,识别与活体均够用。
同人相似度在库内自测为 0.55~0.70(阈值 0.45),不同人之间为 0.06。
小结
项目中的 docs/DEVNOTES.md 记录了 16 个问题。其中包括 ONNX Runtime 安装 GPU 版却无法使用、MJPEG 推流为何不能直接调用 cap.read()、Windows 摄像头为何要指定 DSHOW 与 MJPG 等”能运行但低效”或”能运行但日志污染”的问题。
运行方式:
1 | pip install -r requirements-cpu.txt |
同一 WiFi 下,手机访问 http://内网IP:5000 即可预览。没有摄像头时可运行 python tools/self_test.py,用 dataset/ 中的图片模拟视频流,验证整条链路并输出一张带标注的截图。
- 标题: 人脸核验与静默活体
- 作者: mmj
- 创建于 : 2026-11-02 13:45:00
- 更新于 : 2026-11-02 14:39:54
- 链接: https://samzhaohx.github.io/2026/11/02/人脸核验与静默活体/
- 版权声明: 本文章采用 CC BY-NC-SA 4.0 进行许可。